[논문 요약]YOLO v2
이번에는 YOLO v2 Document를 읽고서 정리해보았다.
Introduction
일반적인 Object Detection은 fast, accurate, and a wide variety of objects 를 하도록 제안한다.
Neural network가 소개된 이후, detection은 점점 빨라지고 정확해졌다. 하지만 대부분 detection method들은 여전히 작은 object에 제한된다.
현재 Object Detection dateset들은 classification과 tagging 같은 dataset들과 비교하면 제한된다.논문에서는 Classification 수준의 스케일을 detection하고 싶은데 비용적인 측면이 너무 크다.
그래서 이미 가지고 있는 수많은 Classification 데이터를 이용하여 별개의 dataset들은 함께 결합할 수 있는 hierarchical view of object classification을 제안한다.
또한, detection과 classification 데이터로 object detector를 학습시키는 joint training algorithm을 제안한다.
Better
기존의 YOLO는 다양한 단점들을 가지고 있는데, Error 분석에서 Fast R-CNN과 비교했을 때 중대한 localization error를 발생시킨다. 게다가 YOLO는 region proposal을 기반으로 한 방법들과 비교했을 때 낮은 recall(재현율)을 보였다.
논문에서는 낮은 recall과 localization error에 대해 개선하면서 classification accuracy를 유지하는데 집중하기로 했다.
Batch Normalization
Batch Normalization은 일반적으로 regularization 효과를 가져오기 때문에, 학습 수렴이 더 잘되게 됩니다. 기존 YOLO의 convolution layer들에 Batch Normalization을 추가하면서 2% 이상의 mAP 향상했다. 또한, model이 정규화하는데 도움을 주었고 Dropout layer를 제거해도 overfitiing이 없었다.
High Resolution Classifier
모든 state-of–the-art detection 방법들은 ImageNet 데이터에서 학습시킨 pre-trained classifier를 사용하는데, classifier의 입력이 256x256보다 작다. 기존의 YOLO는 입력이 244 x 244인 classifier pre-train 모델로 사용하면서 입력 사이즈를 448 x 448로 증가시켜서 object detection model을 학습시켰다.
하지만 YOLO v2의 경우에는 기존의 224x224의 pre-train model을 입력 사이즈를 448x448로 증가시키고 ImageNet에서 10 epoch동안 학습을 더 하고, detection학습을 진행했다. 이를 통해서 4%의 mAP 향상되었다.
Convolutional With Anchor Boxes
YOLO는 fully-connected layer들을 사용하면서 직접 bounding box들의 좌표들을 예측한다. Faster R-CNN은 좌표를 직접 예측하는 대신에 이전의 hand-piked를 사용하여 예측한다.
먼저 fully connected layer를 빼고, Pooling Layer 하나를 빼서, Convolution Layer의 해상도를 늘렸다고 한다. 그리고 기존의 448x448 입력 크기를 416x416로 변경했는데, 이렇게 되면, 최종 feature map에서 width 및 height가 홀수가 되서, 가운데 cell이 존재할 수 있게 된다. 이렇게 만든 이유는 일반적으로 큰 image들은 정 가운데 cell에 들어가는 경우가 많은데, feature map이 짝수일 경우에 center 근방의 cell 4개가 이러한 큰 object를 예측하게 되는데, 이렇게 사용하는 것 보다 feature map이 홀수 width, height로 떨어져서 single cell이 생길 경우 성능이 더 좋아진다고 한다. YOLOv2는 downsample factor가 32고, 최종 feature map의 크기는 13x13이 되게 된다.
Anchor Box를 사용하는 경우 accuracy가 살짝 떨어지지만 기존의 YOLO가 입력 이미지 당 98개 box를 예측하는게 한계였다면, Anchor Box 적용 후에는 천개 이상으로 box를 예측할 수 있다. Anchor Box를 적용하지 않을 경우 mAP가 69.5에 81%의 recall을 기록했지만, Anchor Box 적용 후에는 69.2%의 mAP와 88%의 recall을 얻을 수 있었다. mAP가 감소했지만 recall이 증가했으므로 모델의 개선 여지가 있는 것으로 의미한다고 받아들인듯 한다.
Dimension Clusters
YOLO와 Anchor Box를 사용하면 2가지의 문제점이 생겼다. 하나는 box dimension들이 hand-pick 된다는 것이다. 이를 네트워크가 학습할 수 있지만, 이전에 좋은 anchor box들을 선택해주면 네트워크가 좋은 방향으로 예측하는 것을 학습하기에 쉽게 만들 수 있다.
손으로 고르는 대신에 training set bounding box에서 k-means clustering을 사용하여 자동적으로 좋은 prior들을 찾는다. 일반적으로 kmeans는 유클리디안 거리를 사용하게 되는데, 이 유클리디안 거리가 큰 박스의 경우에는 작은 박스에 비교했을 때, 큰 에러값을 갖게 된다.
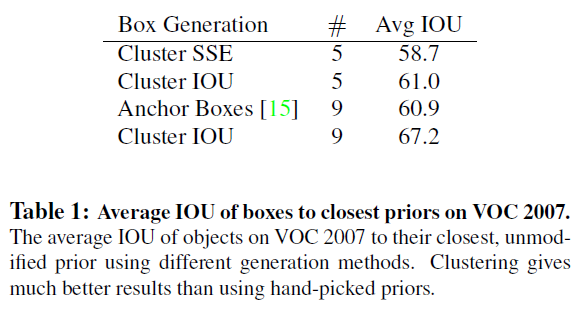
이는 K-means을 사용하여 경계 상자를 생성하면 모형을 보다 잘 표현하고 작업을 보다 쉽게 학습할 수 있음을 나타냅니다.
Direct location prediction
Anchor Box를 사용했을 때, 발생하는 2번째 문제는 모델 불안정성이다. 대부분의 불안정성은 box의 (x, y) 좌표를 예측하는 데에서 생기는데, region proposal 계열의 네트워크들은  값들을 이용해서 (x, y)값들을 예측한다.
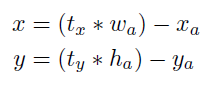
Fine-Grained Features
기존의 Faster R-CNN이나 SSD는 네트워크가 가지고있는 다양한 해상도의 feature map을 proposal networks를 돌려서 얻었는데, YOLO9000은 Final Feature map의 size를 13x13으로 변경하고, 이전 layer에서 26x26의 해상도를 갖는 feature map을 passthrough layer를 이용해서 가지고 와서 저해상도 feature map과 concatenates하게 되는데, 이 때 공간을 맞춰서 concatenate하는게 아니라 다른 채널에 stacking하게 된다.
이러한 방식이 ResNet의 ID Mapping과 유사한 방식이라고 한다. 방법은 26x26x512의 feature map을 13x13x2048 feature map에 stacking하게 된다. 이런 형태로 고해상도의 feature map을 가져와서 쓰게 되면 1%의 성능향상이 일어나게 된다고 한다.
Multi-Scale Training
기존 YOLO에서 사용하던 입력크기를 448x448를 416x416으로 변경하고, Anchor Box도 도입했지만, YOLO가 Pooling layer를 사용해서, feature map의 정보들이 layer를 지나면 지날 수록 계속 작아진다.
논문에서는 YOLO를 다양한 이미지들 속에서 강인하게 만들고 싶어서 모델 학습시 Input Size를 변경해주면서 학습해주자고 한다. 몇몇 iteration마다 model의 input 크기를 변경해주게 되는데, 10 batch 마다 model의 downsample factor가 32인걸 고려해서 {320, 352, …, 608} 중 임의로 image dimension size를 선택하여 학습해주게 된다.
따라서 YOLOv2는 최소 (320 x 320}에서 최대 {608x608}의 네트워크에서 학습되게 된다. 덕분에 네트워크는 다양한 스케일에 대해서 강인성을 갖게되고, 속도와 accuracy사이에서 쉽게 trade off를 전환할 수 있다. 제일 작은 resolution으로 forward operation을 하게 되면(해상도 288 x 288) 90 FPS/Fast R-CNN정도의 mAP로 detection을 할 수 있고, 제일 큰 resolution(608x608)일 경우에는 VOC2007에서 78.6mAP를 갖으면서 여전히 real-time speed를 갖는 네트워크 모델로 사용할 수 있다.