[논문 요약]YOLO v1
Deeplearing YOLO v1 Document를 읽고서 정리해보았다.
Object Tracking을 Deeplearning의 기술인 YOLO를 이용하여 하기 위해서 YOLO v1 Document를 읽고서 정리해보았다.
Introduction
사람은 어떤 이미지를 봤을 때, 이미지 내부에 있는 Object들의 디테일을 한 눈에 파악할 수 있다. (Object가 무엇인지, 어디에 위치해있는지, 그들은 어떤 관계에 있는지 등) 적은 의식적 사고의 개입으로도 운전과 같은 복잡한 행위를 할 수 있는 이유도 여기에 있다. 그러나, 근래의 R-CNN과 같은 detection system들은 복잡한 처리과정으로 인해 이러한 Human visual system을 모방하기에는 부족한 부분들을 보인다. (느린 속도, 최적화의 어려움)
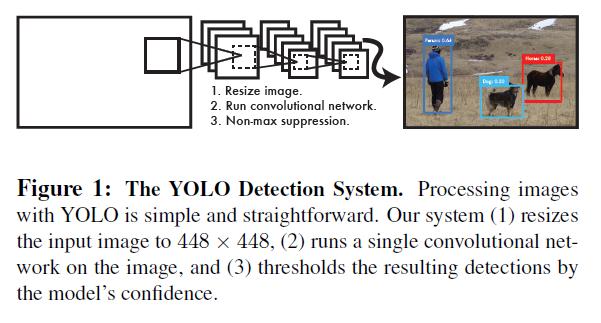
YOLO(You Only Look Once)는 이미지 내의 bounding box와 class probability를 single regression problem으로 간주하여, 이미지를 한 번 보는 것으로 object의 종류와 위치를 추측한다. 아래와 같이 single convolutional network를 통해 multiple bounding box에 대한 class probablility를 계산하는 방식이다.
YOLO는 전체 이미지를 학습하고, 즉시 detection performance를 최적화한다.
기존의 Object detection method와 비교했을 때, 몇 가지 장점이 있다.
장점
- 간단한 처리과정으로 속도가 매우 빠르다. detection을 regression problem으로 간주하기 때문에 complex pipeline이 필요없다. 게다가 다른 real-time system보다 mAP가 2배 정도 높다.
- Image 전체를 한 번에 바라보는 방식으로 class에 대한 맥락적 이해도가 높다. 이로인해 Fast R-CNN과 비교했을 때, 절반 이상의 낮은 backgound error(False-Positive)를 보인다.
- Object에 대한 좀 더 일반화된 특징을 학습한다. 가령 natural image로 학습하고 이를 artwork에 테스트 했을때, 다른 Detection System들에 비해 훨씬 높은 성능을 보여준다.
단점
- 이미지에서 빨리 object를 식별할 수 있지만, 상대적으로 낮은 정확도 (특히, 작은 object에 대해서)
Unified Detection
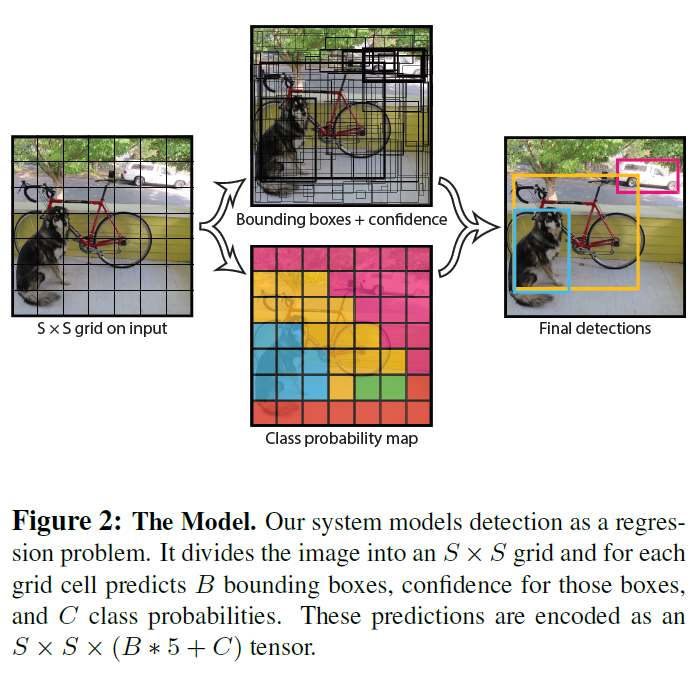
- Input image를 S X S grid로 나눈다.
- 각각의 grid cell은 B개의 bounding box와 각 bounding box에 대한 confidence score를 갖는다. (만약 cell에 object가 존재하지 않는다면 confidence score는 0이 된다.)
- 각각의 grid cell은 C개의 conditional class probability를 갖는다.
- 각각의 bounding box는 x, y, w, h, confidence로 구성된다. (x,y): Bounding box의 중심점을 의미하며, grid cell의 범위에 대한 상대값이 입력된다. (w,h): 전체 이미지의 width, height에 대한 상대값이 입력된다.
Test time에는 conditional class probability와 bounding box의 confidence score를 곱하여 class-specific confidence score를 얻는다.
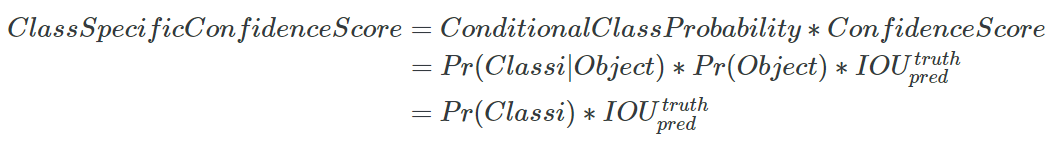
논문에서는 YOLO의 성능평가를 위해 PASCAL VOC을 사용하였으며, S, B, C에는 각각 7, 2, 20이 할당되었다.
Network Design
초기 convolution layer들은 이미지에서 feature를 추출하는 반면에 fully-connected layer들은 the output probabilities and coordinates를 예측한다.
YOLO의 network architecture는 GoogLeNet for image classification 모델을 기반으로 한다. (24 Convolutional layers & 2 Fully Connected layers)
GoogLeNet에서 사용하는 초기 모듈 대신에, 1 X 1 reduction layers와 3 X 3 convolutional layers 를 사용한다. 전체 네트워크는 Figure 3이다.
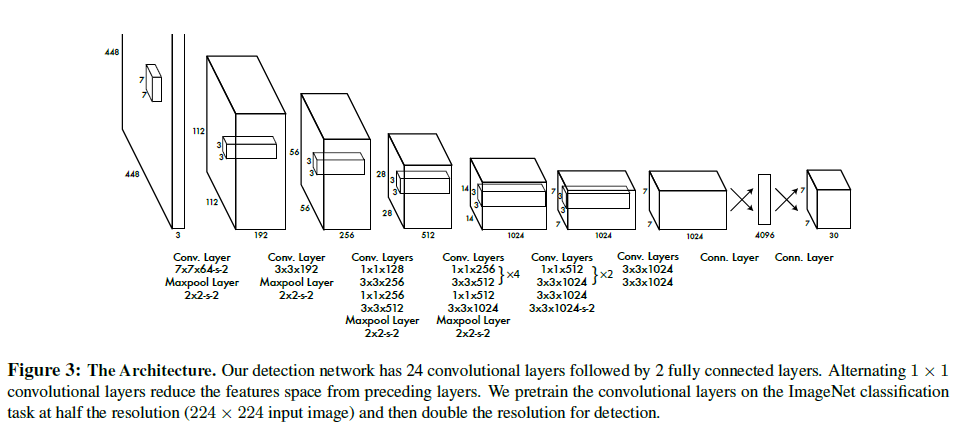
또한, YOLO의 빠른 버전인 Fast YOLO는 위 디자인의 24의 convolutional layer를 9개의 convolutional layer로 대체한다.)
모든 training, testing 값은 YOLO와 Fast YOLO 둘 다 같다.
Limitations of YOLO
- 각각의 grid cell이 두 개의 BBox와 하나의 클래스만을 예측할 수 있으므로, 작은 object 여러개가 다닥다닥 붙으면 제대로 예측하지 못한다.
- bounding box의 형태가 training data를 통해서만 학습되므로, 새로운/독특한 형태의 bouding box의 경우 정확히 예측하지 못한다.
- 큰 박스에 작은 error는 일반적이지만 작은 박스에 작은 error는 IOU에 큰 영향을 미친다. 몇 단계의 layer를 거쳐서 나온 feature map을 대상으로 bouding box를 예측하므로 localization이 다소 부정확해지는 경우가 있다.